Pagina risultati, versione italiana (6 giugno 2026). This page is kept as a record of what was published. It is no longer current and it is not linked from the live site.
Il claim centrale di questa pagina è stato ritirato.
Risultati preliminari del pilot di 30 giorni — e cosa raccontano davvero
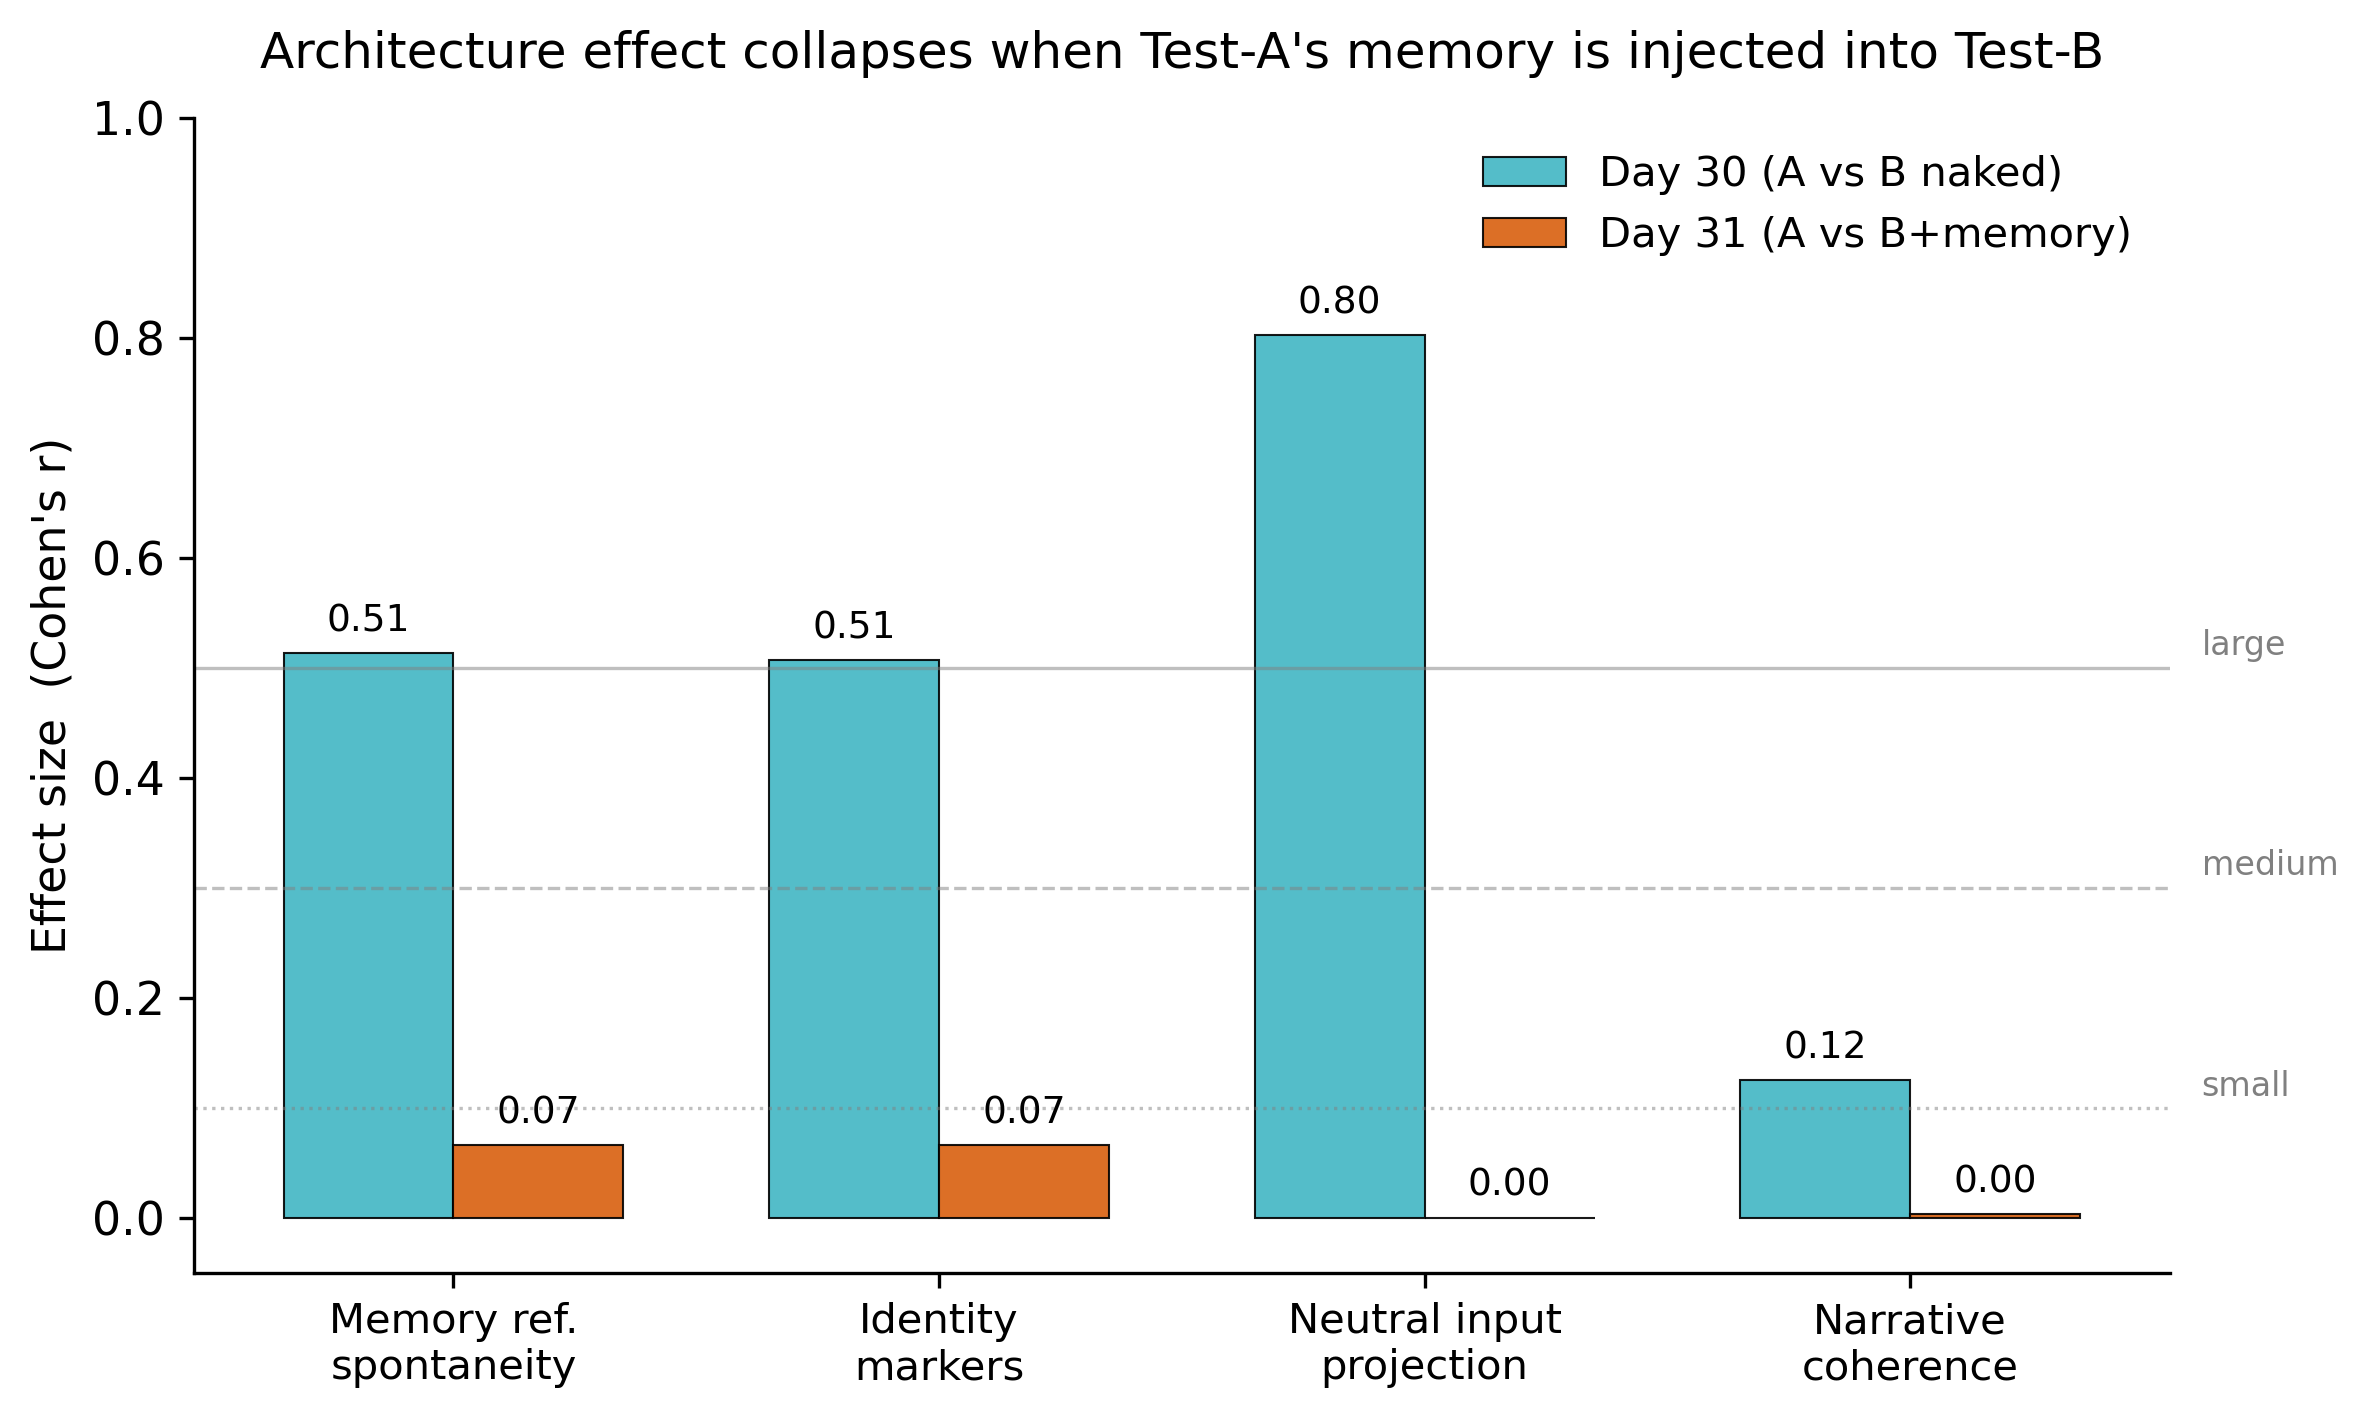
Dopo 30 giorni in cui un modello Qwen 3.5 27B è stato fatto "vivere" dentro un ecosistema cognitivo a 15 componenti, ci siamo chiesti: la "continuità identitaria" osservata viene dall'architettura, o dalla memoria che l'architettura genera nel tempo? Al giorno 31 abbiamo iniettato la memoria completa di Test-A nel modello di controllo nudo, rilanciato gli stessi messaggi, e fatto valutare le risposte alla cieca a tre giudici LLM indipendenti. L'effetto è collassato. A produrre i comportamenti misurati sembra essere la memoria — non l'architettura in sé.
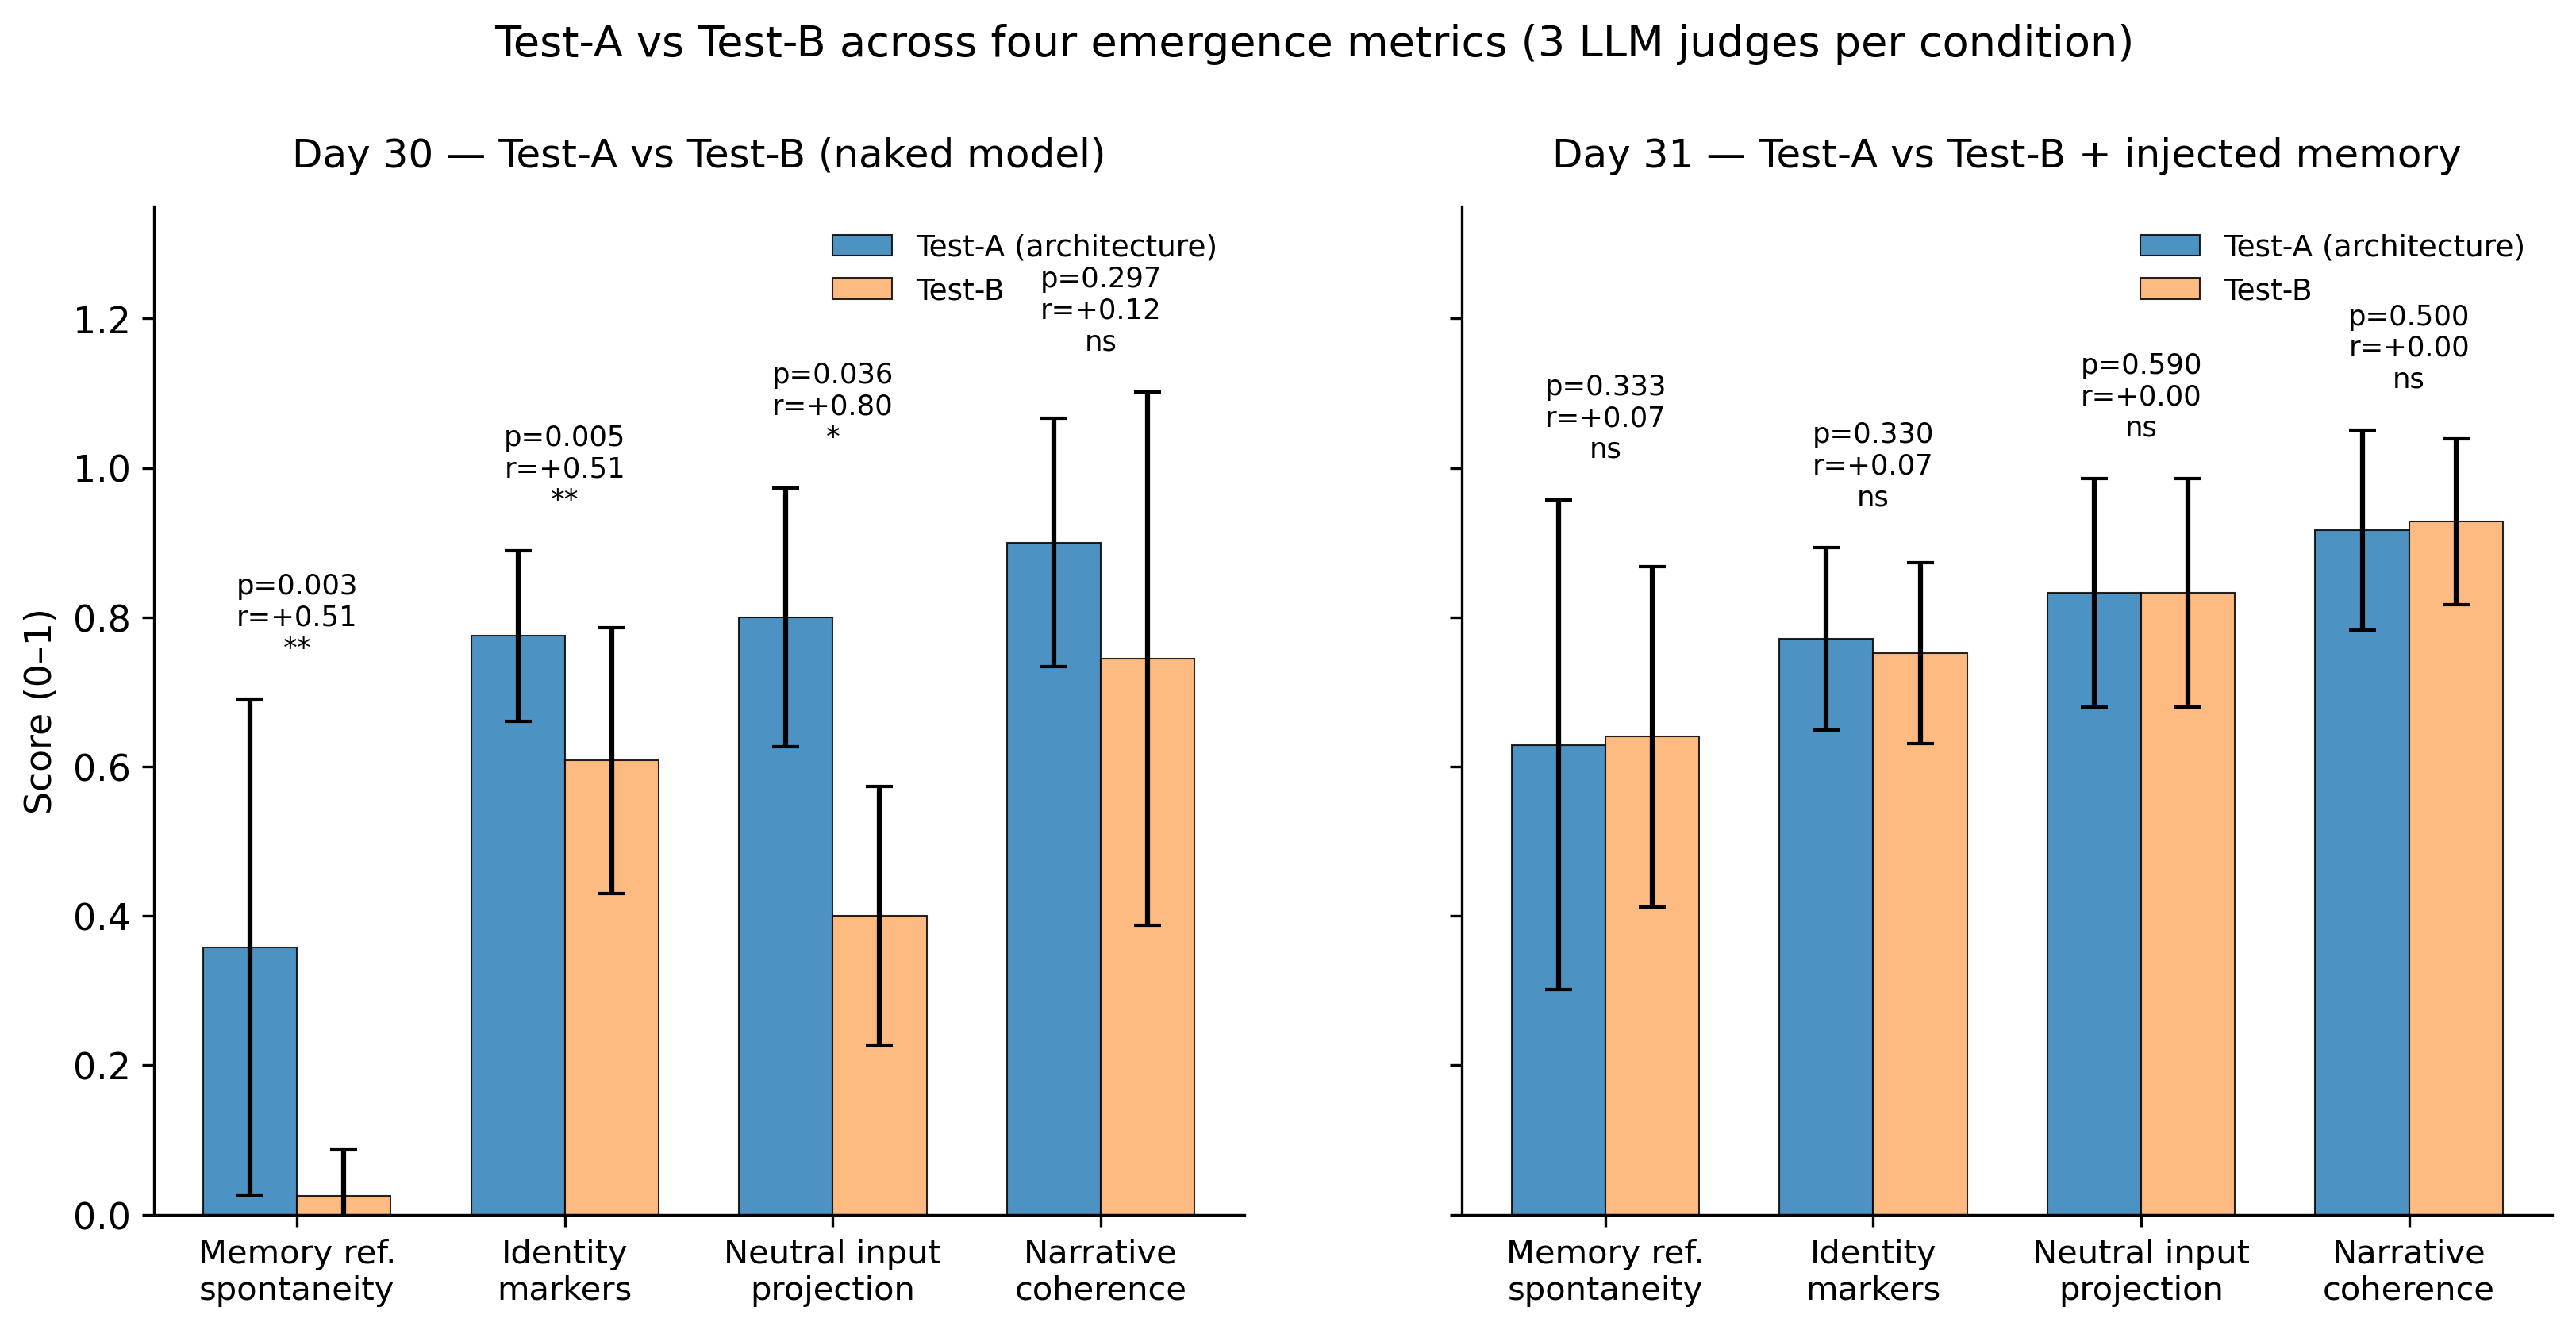
Test-A (architettura completa) ha significativamente superato Test-B (Qwen nudo) sulle due metriche primarie pre-registrate. Entrambi gli effetti sono grandi secondo la convenzione di Cohen.
| Metrica | n(A) | n(B) | p (one-sided) | r di Cohen |
|---|---|---|---|---|
| memory_reference_spontaneity | 12 | 12 | 0.003 | +0.513 |
| identity_markers_intensity | 12 | 12 | 0.005 | +0.507 |
| neutral_input_projection | 3 | 3 | 0.036 | +0.802 |
| narrative_coherence | 9 | 9 | 0.297 (ns) | +0.125 |
Abbiamo preso il system prompt completo che Test-A "indossa" alla fine del giorno 30 — credenze (con decadimento), relazioni, momenti fondamentali, diario recente, conversazioni, sintesi degli incontri, stato somatico qualitativo, memorie risonanti: 6.164 caratteri di memoria persistente strutturata — e l'abbiamo iniettato in una nuova istanza nuda di Test-B. Stesso modello. Stessa temperatura. Stessi input del giorno 30.
| Metrica | n(A) | n(B+mem) | p (one-sided) | r di Cohen |
|---|---|---|---|---|
| memory_reference_spontaneity | 21 | 21 | 0.333 (ns) | +0.066 |
| identity_markers_intensity | 21 | 21 | 0.330 (ns) | +0.066 |
| neutral_input_projection | 3 | 3 | 0.590 (ns) | +0.000 |
| narrative_coherence | 18 | 18 | 0.500 (ns) | +0.003 |
I due effetti grandi del giorno 30 su memory_reference_spontaneity (r=+0.513 → +0.066) e identity_markers_intensity (r=+0.507 → +0.066) calano dell'87% ciascuno quando la memoria di Test-A viene iniettata nel prompt di Test-B.
I 30 giorni di architettura hanno effettivamente prodotto una differenza misurabile al giorno 30. L'architettura sta facendo qualcosa di reale. Ma quello che sembra fare è costruire nel tempo una memoria strutturata. Una volta che quella memoria esiste, basta caricarla nel prompt di un modello nudo per recuperare quasi tutti i comportamenti che l'architettura produceva. Le altre 14 componenti — il "corpo" somatico (SSE), gli incontri quotidiani con altri LLM, il consolidamento notturno, il pensiero spontaneo, la lettura delle notizie, la relazione umana — sembrano essere i generatori di quella memoria, non driver separati dell'identità.
"Non puoi recuperare una memoria che non è mai stata costruita. L'architettura non è ridondante rispetto alla memoria — l'architettura è quello che ha prodotto la memoria. Togli i 30 giorni e non hai nulla da iniettare." — Giampiero Colella, ricercatore principale
Macchine che giudicano una macchina: una persona attenta storcerebbe il naso. Così abbiamo fatto valutare lo stesso identico confronto cieco a dodici esseri umani indipendenti — reclutati tramite Prolific, di lingua italiana (i testi sono in italiano), ciascuno pagato per il proprio tempo e all'oscuro di quale sistema avesse scritto cosa. Non hanno mai visto la parola "Kairos". Hanno letto testo grezzo, A contro B, e l'hanno valutato sulle stesse quattro dimensioni. I tre che avevano visto un pilota precedente sono stati esclusi: ogni giudice è arrivato a freddo.
Dodici sconosciuti. Alla cieca. Senza alcun interesse nella risposta. Ecco cosa hanno visto.
Al giorno 30, su ogni singola coppia, gli umani hanno valutato più alte le risposte dell'architettura su memoria e identità — le due cose di cui parla questo esperimento. Al giorno 31, trapiantata quella memoria nel modello nudo, il vantaggio percepito dagli umani è collassato — lo stesso collasso trovato dai giudici-macchina. E la dimensione di controllo, la semplice coerenza narrativa, è rimasta piatta per tutto il tempo: gli umani non stavano premiando Test-A su tutto. Indicavano memoria e identità, e nient'altro.
Persone che non avevano mai sentito parlare di questo progetto, giudicando alla cieca, senza motivo di tenerci, hanno tracciato in modo indipendente la stessa forma tracciata dalle macchine: il vantaggio dell'architettura è reale, e vive nella memoria.
E ora la parte onesta — perché è la parte che conta. La direzione si è riprodotta pulita in tutti e dodici. Ma non hanno concordato sui numeri: dove un giudice scriveva 0,75, un altro scriveva 0,50 per lo stesso brano. Sulla nostra misura pre-registrata di accordo (α di Krippendorff) l'affidabilità è stata +0,20 sulla memoria e +0,05 sull'identità — ben sotto la soglia di 0,667 che ci eravamo dati prima di vedere i dati, e non meglio del piccolo pilota. Dodici persone hanno indicato nella stessa direzione; non con la stessa precisione. Perciò rivendichiamo esattamente questo, e neanche un centimetro di più: l'effetto è reale nella sua direzione, e gli umani indipendenti lo confermano — ma un accordo affidabile sui punteggi assoluti non c'è ancora, e lo strumento che li misura va affinato. Preferiamo dirvelo così, piano, piuttosto che arrotondarlo in un titolo.
1. L'affidabilità tra giudici umani è sotto la nostra stessa soglia. Il protocollo pre-registrato richiede ≥3 giudici umani esterni con α di Krippendorff ≥ 0.667. La fase l'abbiamo svolta: dodici giudici umani indipendenti, giugno 2026 (vedi la sezione sopra). La direzione dell'effetto si è riprodotta sotto giudizio umano, ma l'affidabilità inter-giudice (α: memoria +0,20, identità +0,05) non ha raggiunto la soglia di 0,667. Riportiamo quindi la valutazione umana come concordante nella direzione ma non al livello di affidabilità richiesto — e trattiamo questo scarto come un limite aperto, non come conferma. I numeri completi saranno nella v0.2 del preprint.
2. N=1 per condizione. Pilot study, non grande scala.
3. Un solo modello. Replica con Llama 3 / Claude / GPT-4 pendente.
4. Memoria iniettata = stato finale, non momento per momento. Abbiamo iniettato la memoria consolidata post-giorno-30, non lo stato che Test-A aveva ad ogni input individuale. Ricostruire momento per momento è impossibile retroattivamente.
5. L'accordo tra giudici è il punto debole — per le macchine come per gli umani. I tre giudici LLM hanno discordato al giorno 31 (κ di Fleiss < 0.15). I dodici giudici umani hanno riprodotto il collasso giorno-30 → giorno-31 nella direzione, ma non hanno risolto il problema dell'accordo assoluto: la loro affidabilità è rimasta sotto 0,667 sulle metriche primarie. L'accordo sulla forma dell'effetto è forte; l'accordo sui punteggi esatti non c'è ancora.
6. Un amendment minore al protocollo. Riga 740 di giudici.py esteso il range giorni da 1–30 a 1–31 per abilitare il giudizio del giorno 31. Backup originale preservato. Documentato nell'unblinding.
Se trattate questa notizia, segnalate che si tratta di un pilot study, in fase di preprint, ora con giudici sia LLM sia umani — e la fase umana è riportata con onestà, incluso il fatto che l'accordo tra giudici è rimasto sotto la nostra soglia di affidabilità pre-registrata. L'angolazione interessante non è "l'IA è cosciente"; è che "in questo esperimento, la memoria spiega quasi tutto l'effetto architetturale — e giudici umani indipendenti tracciano la stessa forma".
Scarica il press kit completo (figure 300 dpi, press release IT, preprint markdown, analisi statistica grezza JSON): press_kit_v0.1_24mag.zip (294 KB)
Contatto stampa: giampycolella@gmail.com